



[IT News] AI 코딩 에이전트의 성능은 모델 자체만으로 결정되지 않는다. 모델을 실제 개발 환경에서 구동하는 ‘하네스(harness)’의 선택에 따라 같은 모델이라도 비용이 최대 5배까지 달라질 수 있다는 연구 결과가 나왔다.
캘리포니아대 버클리캠퍼스와 AI 평가 플랫폼 아레나(Arena)의 공동연구진은 최근 ‘HarnessTax: How Much Does the Harness Matter for Coding Agents?’라는 연구에서 AI 코딩 에이전트의 모델과 하네스를 분리해 평가했다. 연구진은 7개 모델과 3개 하네스를 조합한 21개 조합을 두 벤치마크에서 비교한 결과, 작업 성공률은 크게 차이 나지 않았지만 비용은 최대 5배 차이가 났다고 밝혔다.
하네스란 무엇인가
하네스는 AI 모델이 실제 작업을 수행할 수 있도록 돕는 소프트웨어 실행 기반을 뜻한다. 모델이 ‘생각’을 담당한다면 하네스는 파일을 읽고 수정하거나, 명령을 실행하거나, 도구를 호출하고, 작업 결과를 반복 확인하는 역할을 맡는다.
일반적으로 하네스는 시스템 프롬프트, 도구, 에이전트 루프, 변환 계층으로 구성된다. AI 모델에 역할과 규칙을 알려주고, 코드 실행·검색·파일 편집 같은 기능을 제공하며, 작업 결과를 바탕으로 다음 행동을 반복적으로 결정하게 한다.
즉, 사용자가 ‘Claude’나 ‘GPT’ 같은 모델만 선택한다고 해서 AI 코딩 에이전트의 성능과 비용이 확정되는 것은 아니다. 모델을 감싸는 실행 환경, 즉 하네스 역시 함께 선택해야 한다.
같은 모델, 최대 5배 비용 차이
연구진은 Claude Code, Codex CLI, Pi라는 3개 하네스를 대상으로 Claude Fable 5, Claude Opus 4.8, Claude Sonnet 4.6, Claude Haiku 4.5, GPT-5.6 Sol, GPT-5.6 Luna, Kimi K3 등 7개 모델을 조합해 평가했다. 평가에는 소프트웨어 버그 수정 능력을 측정하는 SWE-bench Lite와 명령줄 환경의 복잡한 작업을 평가하는 Terminal-Bench 2.0이 사용됐다.
각 벤치마크에서 무작위로 선정한 30개 과제를 21개 조합으로 각각 3회씩 수행했으며, 각 시도는 최대 100턴으로 제한했다. 성공 여부는 각 벤치마크가 제공하는 공식 평가 프로그램으로 판정했다.
결과, 하네스가 다르다고 해서 과제 해결 성공률이 크게 달라지지는 않았다. SWE-bench Lite에서는 하네스에 따른 평균 성공률 차이가 ±2% 이내였고, Terminal-Bench 2.0에서도 대체로 ±5% 이내에 머물렀다.
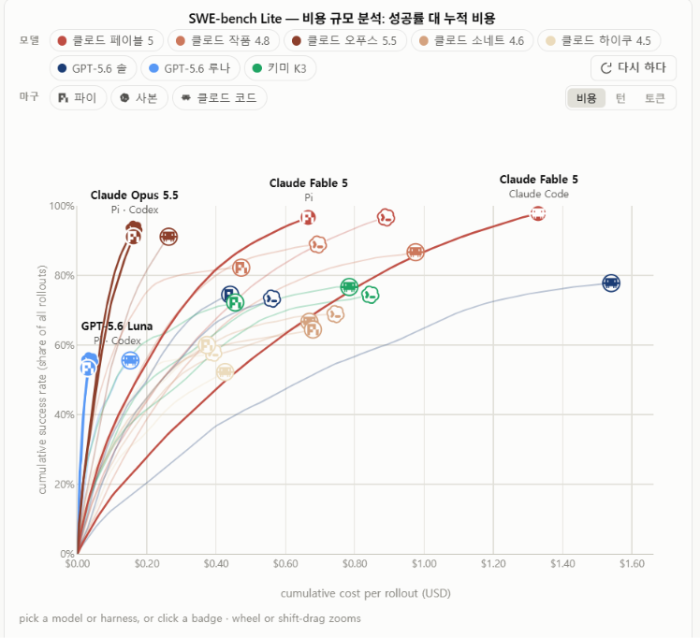
반면 비용 차이는 뚜렷했다. 같은 모델이라도 하네스에 따라 최대 5배까지 비용 차이가 발생했다. 연구진은 이를 ‘하네스 세금(Harness Tax)’이라고 표현했다. 즉, 거의 같은 품질의 결과를 얻기 위해 불필요하게 더 많은 비용을 지불하는 현상이다.
Claude Code, Pi보다 약 2배 비용
대표적인 사례는 Claude Fable 5다. 이 모델은 Claude Code에서 시도의 97.8%를 해결했고, Codex CLI와 Pi에서는 각각 96.7%를 해결했다. Claude Code의 성공률이 약간 높았지만, 비용은 Pi의 약 2배였다.
Pi는 평균 15.4턴, Claude Code는 평균 15.3턴을 사용해 사실상 비슷한 작업량을 보였다. 그럼에도 Claude Code의 비용은 약 2배였고, 성공률 상승폭은 1.1%포인트에 불과했다.
공통으로 사용할 수 있는 모델을 기준으로 보면, SWE-bench Lite에서 Claude Code의 비용은 Pi의 약 2배, Codex CLI의 약 1.6배였다. Terminal-Bench 2.0에서도 Claude Code는 Pi보다 약 1.5배 비쌌다.
연구진은 이런 비용 차이의 출발점이 첫 번째 모델 호출에 담기는 초기 맥락(context)이라고 분석했다. Claude Code는 Pi보다 긴 지시문과 큰 도구 정의를 모델에 전달했으며, 7개 모델 전체 평균 기준 초기 맥락은 Pi의 10배 이상이었다.
다만 초기 맥락이 클수록 반드시 전체 비용이 커지는 것은 아니다. 캐시 활용 여부, 모델이 생성하는 토큰 양, 이후 호출 횟수 등도 최종 비용에 영향을 미친다.
기능이 많다고 좋은 것은 아니다
주목할 점은 기능이 풍부한 하네스가 반드시 유리하지 않았다는 사실이다. 오픈소스 하네스 Pi는 파일 읽기(read), 쓰기(write), 편집(edit), 셸 실행(bash)이라는 4개 기본 도구만 제공하는 매우 단순한 구조다.
그럼에도 Pi는 SWE-bench Lite와 Terminal-Bench 2.0 모두에서 비용 대비 성능의 균형을 나타내는 ‘파레토 프론티어’에 진입했다. 이는 하네스의 복잡성이나 기능 수가 곧 성능 향상으로 이어지지 않을 수 있음을 보여준다.
연구진은 “풍부한 기능이 성공률 향상으로 직결되는 것은 아니다”라고 지적했다. 실제 비용은 도구 수뿐 아니라 지시문과 도구 정의의 길이, 모델 호출 횟수, 생성 토큰 양 등이 결합해 결정된다.
제조사 조합이 최선은 아니다
또 하나의 의외의 결과는 모델 제조사가 제공하는 하네스가 항상 최적 조합은 아니라는 점이다. Anthropic의 모델과 Claude Code, OpenAI의 모델과 Codex CLI처럼 같은 회사가 모델과 실행 환경을 함께 최적화한 경우에도, 해당 조합이 가장 우수한 결과를 보이지 않았다.
Anthropic과 OpenAI의 6개 모델을 두 벤치마크에서 비교한 12개 조합 가운데, 9개에서는 모델 제조사와 다른 하네스가 가장 높은 성공률을 기록했다.
예를 들어 SWE-bench Lite에서 Claude Sonnet 4.6은 Codex CLI에서 68.9%의 성공률을 보여 Claude Code의 66.7%를 앞섰다. 두 조합의 비용은 비슷한 수준이었다.
Terminal-Bench 2.0에서는 GPT-5.6 Sol이 Pi에서 83.3%의 성공률을 기록해 Codex CLI의 78.9%를 넘어섰다. Pi의 비용은 Codex CLI의 약 절반이었다.
“모델만 보지 말라”
연구진은 “모델의 능력은 특정 하네스에 완전히 종속되지 않으며, 다른 하네스로도 이전될 수 있다”고 평가했다. 따라서 중요한 것은 모델 제조사가 어디인지가 아니라, 실제 작업에서 어떤 하네스가 비용과 성공률의 균형을 가장 잘 유지하는지라고 강조했다.
다만 이번 결과는 두 개의 오픈소스 벤치마크에 국한됐다. 모델이 해당 범치마크를 학습 과정에서 접했을 가능성도 배제할 수 없다. 실제 개발 환경이나 더 복잡한 작업에서는 더 많은 기능을 갖춘 하네스가 유리할 수 있다.
연구진은 “하네스의 복잡성은 기능의 많고 적음으로 판단해서는 안 되며, 용도별로 비용과 성능을 측정해 평가해야 한다”고 밝혔다.
업계에 주는 시사점
이번 연구는 AI 코딩 에이전트 시장에서 ‘모델 경쟁’만으로는 충분하지 않다는 점을 보여준다. 기업과 개발자는 모델의 벤치마크 점수만 보고 도입을 결정하기보다, 자신의 개발 환경과 작업 유형에 맞는 하네스를 함께 비교해야 한다.
특히 비용이 중요한 기업 환경에서는 같은 모델을 쓰더라도 하네스 선택에 따라 운영비가 크게 달라질 수 있다. 단순한 오픈소스 하네스가 높은 성능과 낮은 비용을 동시에 달성할 수 있다는 점은 국내 개발사와 클라우드 업체에도 새로운 기회로 작용할 수 있다.
AI 에이전트의 경쟁은 이제 ‘더 똑똑한 모델’을 만드는 경쟁을 넘어, 그 모델을 어떻게 효율적으로 움직이게 할 것인가에 대한 ‘하네스 경쟁’으로 확대되고 있다.
김들풀 기자 itnews@